목차
들어가며
2026년 10월 13일, 용인 카카오 AI 캠퍼스에서 열린 if(kakao)26 1일차에 다녀왔다.
조금 늦었지만 참여하여 듣고 느낀 점을 기록해보려고 한다.
올해 슬로건은 "모든 연결에 지능을(Connections Meet Intelligence)" 이였다.
이틀 동안 50여 개 세션이 있었고, 1일차는 AI 방향성과 신뢰·안전 관련 세션이 많았다고 느꼈다.
요즘 실무에서 AI를 붙여 쓰는 일이 늘면서 "잘 동작하는가"보다 "믿고 쓸 수 있는가"가 더 고민이여서 보안, 검색, AI 활용 정책 쪽 세션 위주로 참여했다.
들은 세션
- 키노트
- Agentic AI 시대, 안전한 AI를 위한 카카오의 여정
- 복잡한 질문에서 핵심 근거까지: Agentic Search를 위한 검색 모델링
- "취약점 찾아줘. make no mistakes." 소스코드 보안 분석을 위한 하네스 설계와 인사이트
- 수억건의 보안 신호 속 진짜 위협찾기: AI 적용기 & Agentic AI로 가는길
- AI를 계속 쓰기 위해, 우리가 정한 것들 (파이어사이드챗)
키노트: 필요한 지능을 필요한 만큼
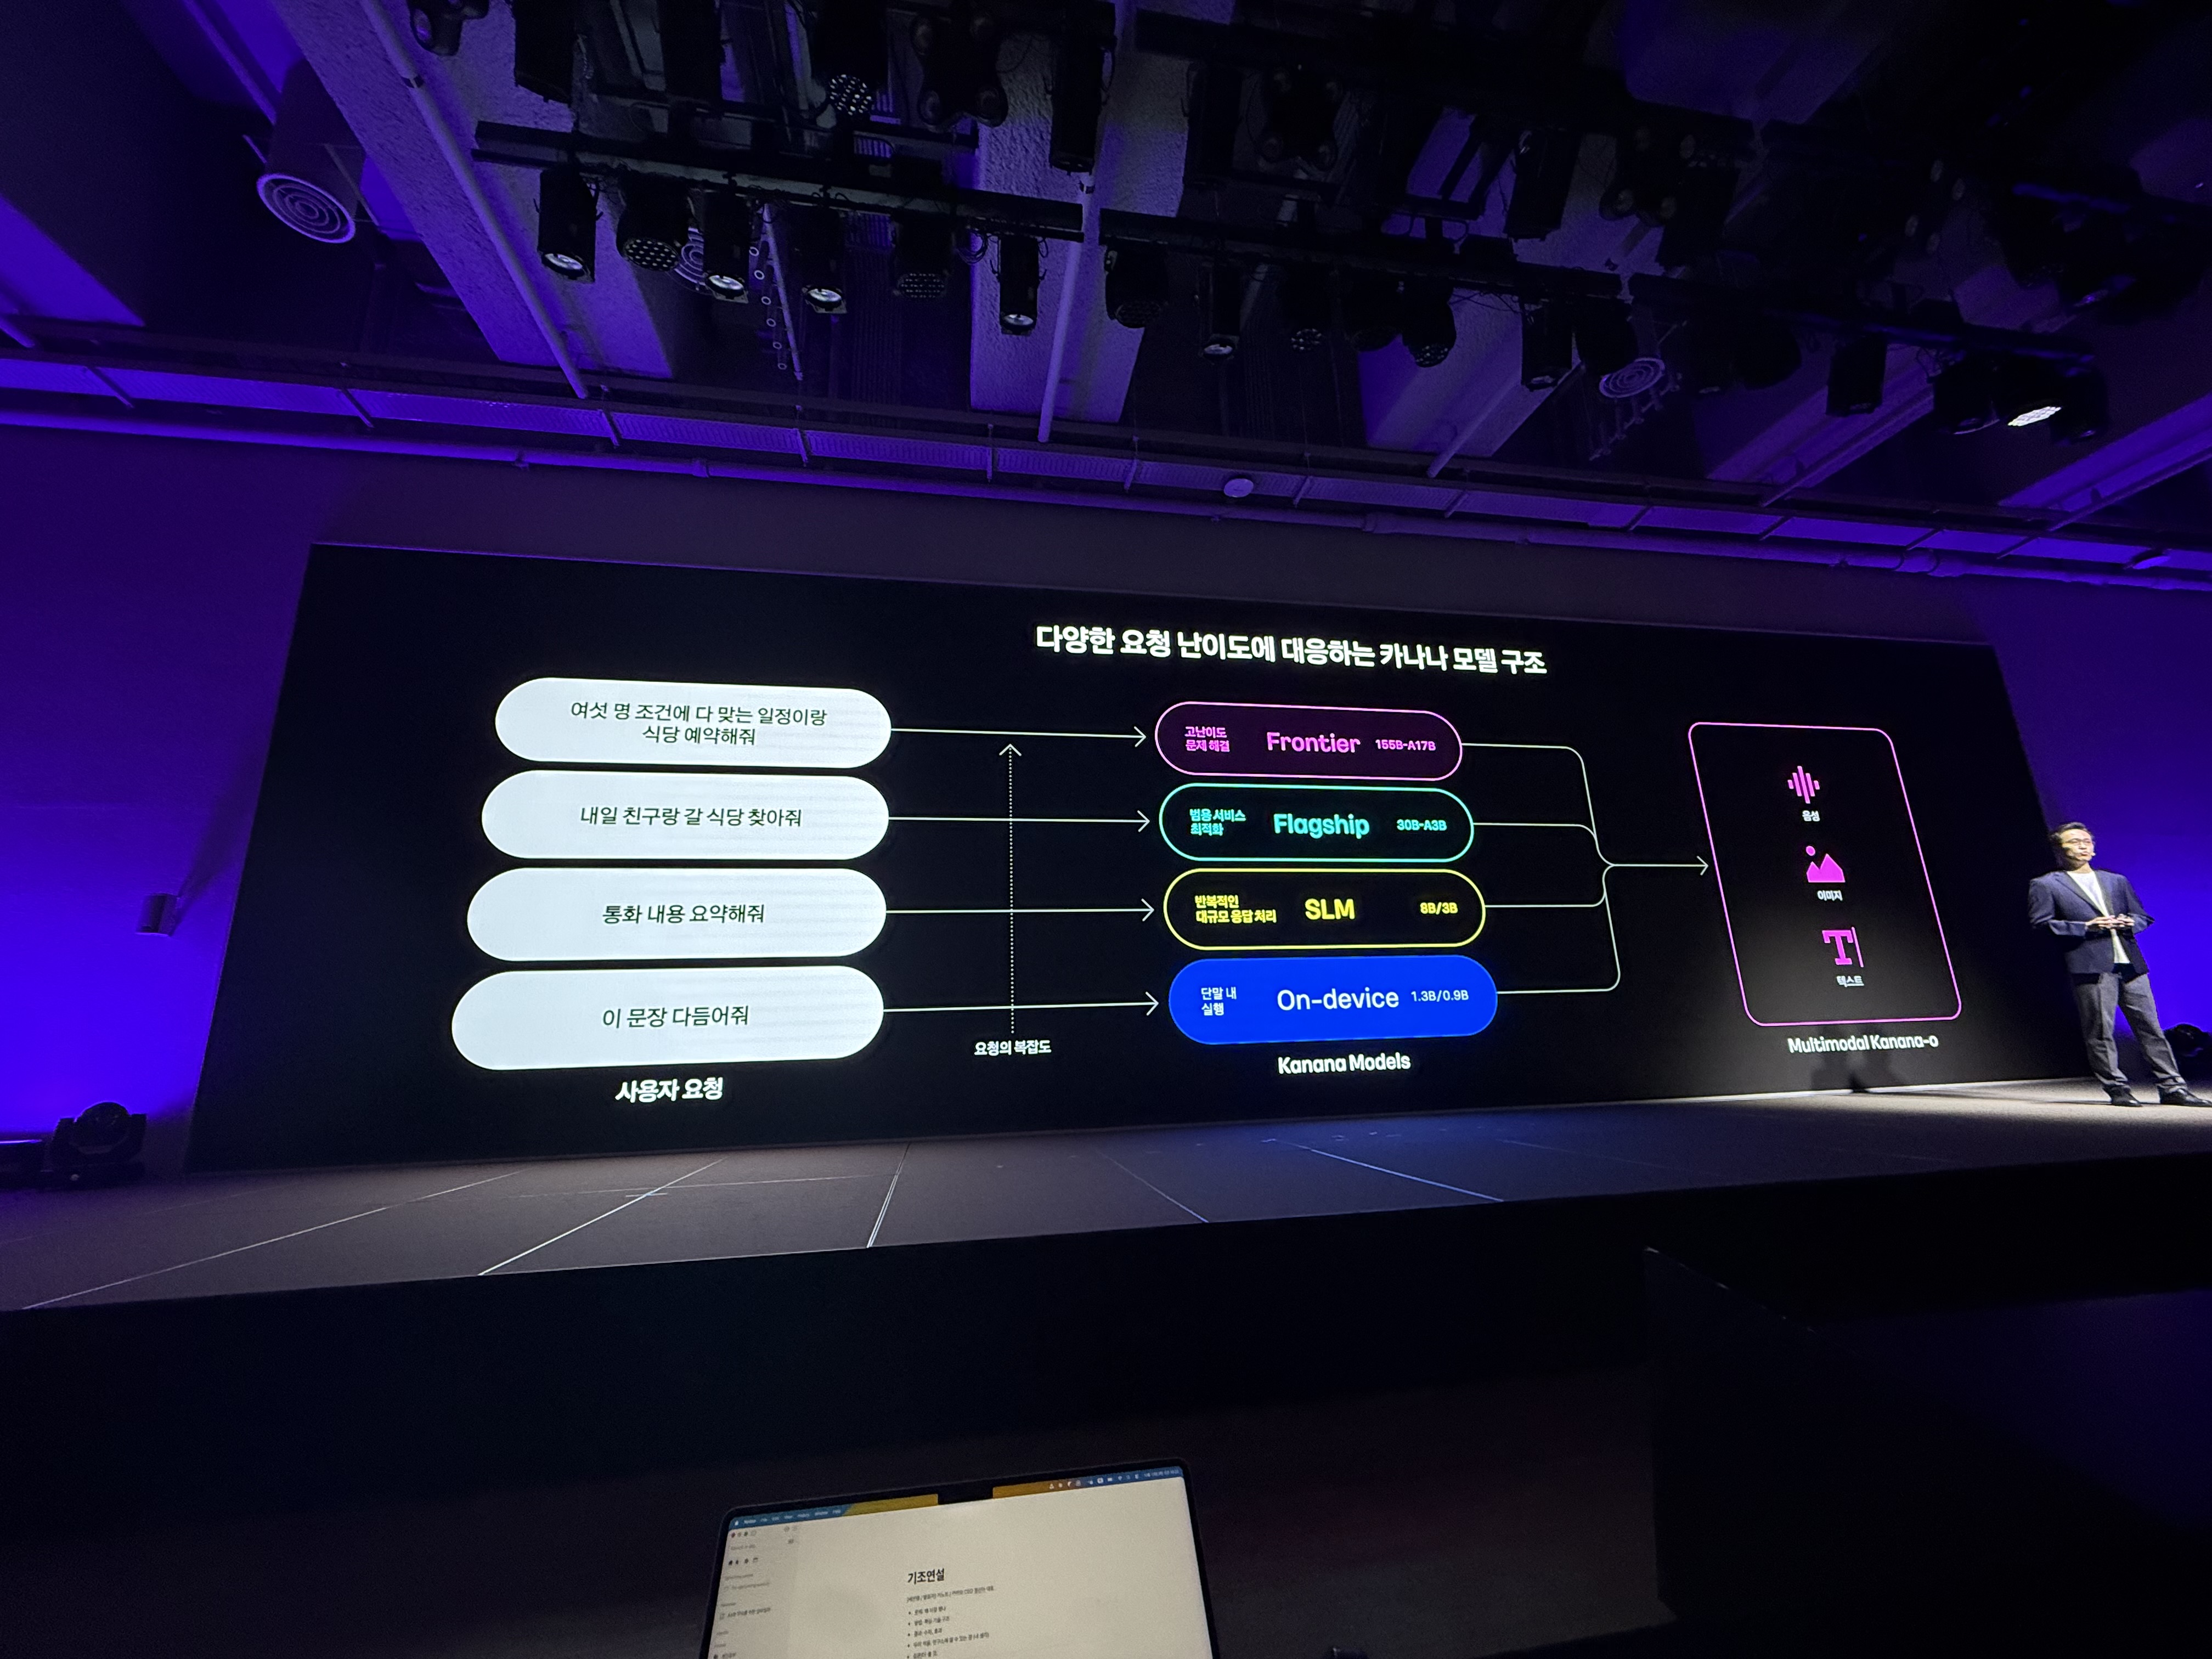
가장 인상 깊었던 건 카나나 모델 구조였다. 요청 난이도에 따라 모델을 나눠서 처리한다.
- Frontier: 고난이도 문제 해결
- Flagship: 범용 서비스
- SLM: 반복적인 대규모 응답 처리
- On-device: 단말 내 실행
"필요한 지능을 필요한 만큼의 연산으로 처리한다"는 방향인데,
모든 것을 가장 좋은 모델에 보내는 게 정답이 아니라는 것을 많이 들었지만 실제 대기업에서 어떤 방식으로 구현했는지 알 수 있어 좋았다.
또 프로젝트 모자이크라는 이름으로, 여러 서비스에 흩어진 사용자 맥락을 "필요한 순간에, 허용된 범위만" 연결하겠다는 방향도 소개됐다.
Agentic AI 시대, 안전한 AI를 위한 카카오의 여정
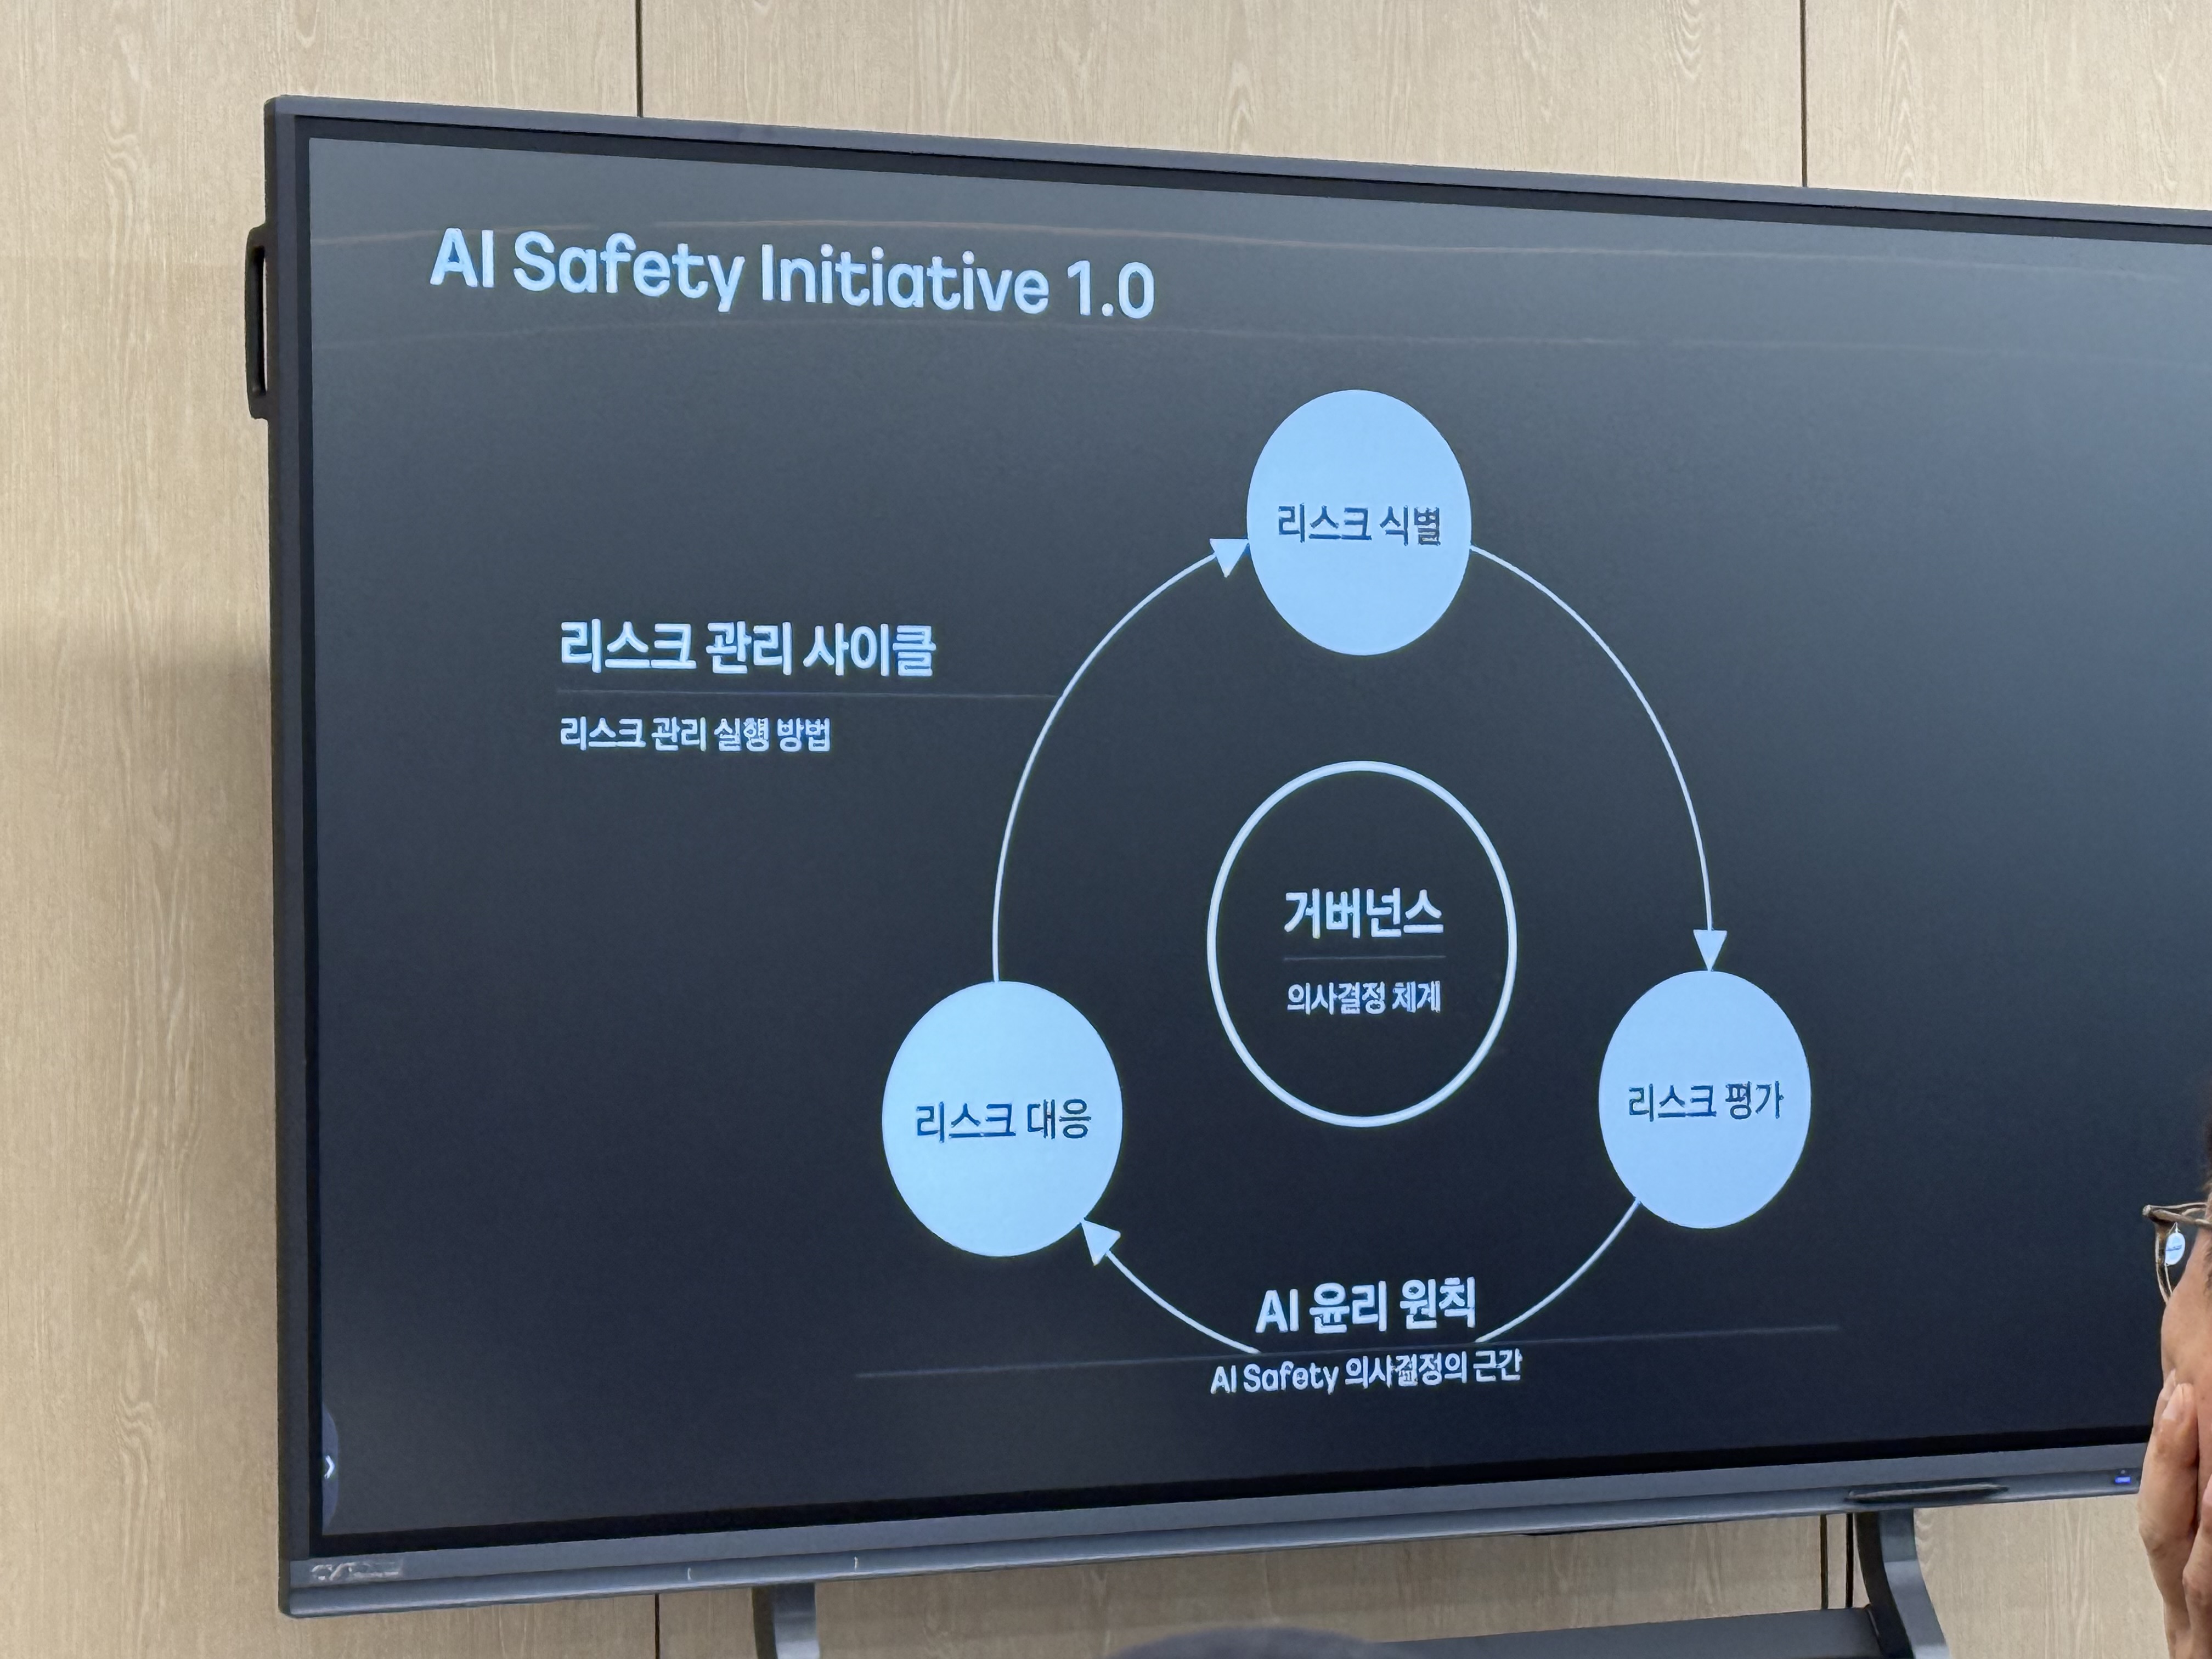
AI 리스크를 식별 → 평가 → 대응하는 체계를 어떻게 만들었는지에 대한 세션이었다.
식별: 모든 AI 활용 건을 하나하나 검토할 수 없으니 가이드라인 체계를 만들었다.
핵심 체크리스트, 사내 활용 정책, 서비스 개발 가이드라인, 투명성 확보 가이드라인, 개발 도구 안전 사용 가이드라인 등
평가: 질문을 하나씩 던져보던 방식에서 평가 파이프라인으로 바꿨다.
질문 자동 생성 → 공격 페이로드 주입 → LLM-as-a-Judge로 자동 채점 → 자동 리포트
대응: Agentic AI는 대화형 AI보다 위험하다. 권한을 잘못 주거나, 목표가 서서히 벗어나거나(목표 드리프트), 프롬프트 인젝션으로 목표 자체가 바뀌는(목표 하이재킹) 문제가 생긴다. 그래서 사용자 발화, 계획 수립, 도구 호출, 결과 저장, 최종 응답 각 단계에 가드레일을 둔다.
AI 답변을 사람이 직접 질문해보며 확인하는 방식은 많은 팀이 하고 있을 것 같다. 이걸 평가 데이터셋과 LLM-as-a-Judge로 자동화하는 건 작은 규모에서도 시도해볼 만하다 생각했다.
Agentic Search를 위한 검색 모델링
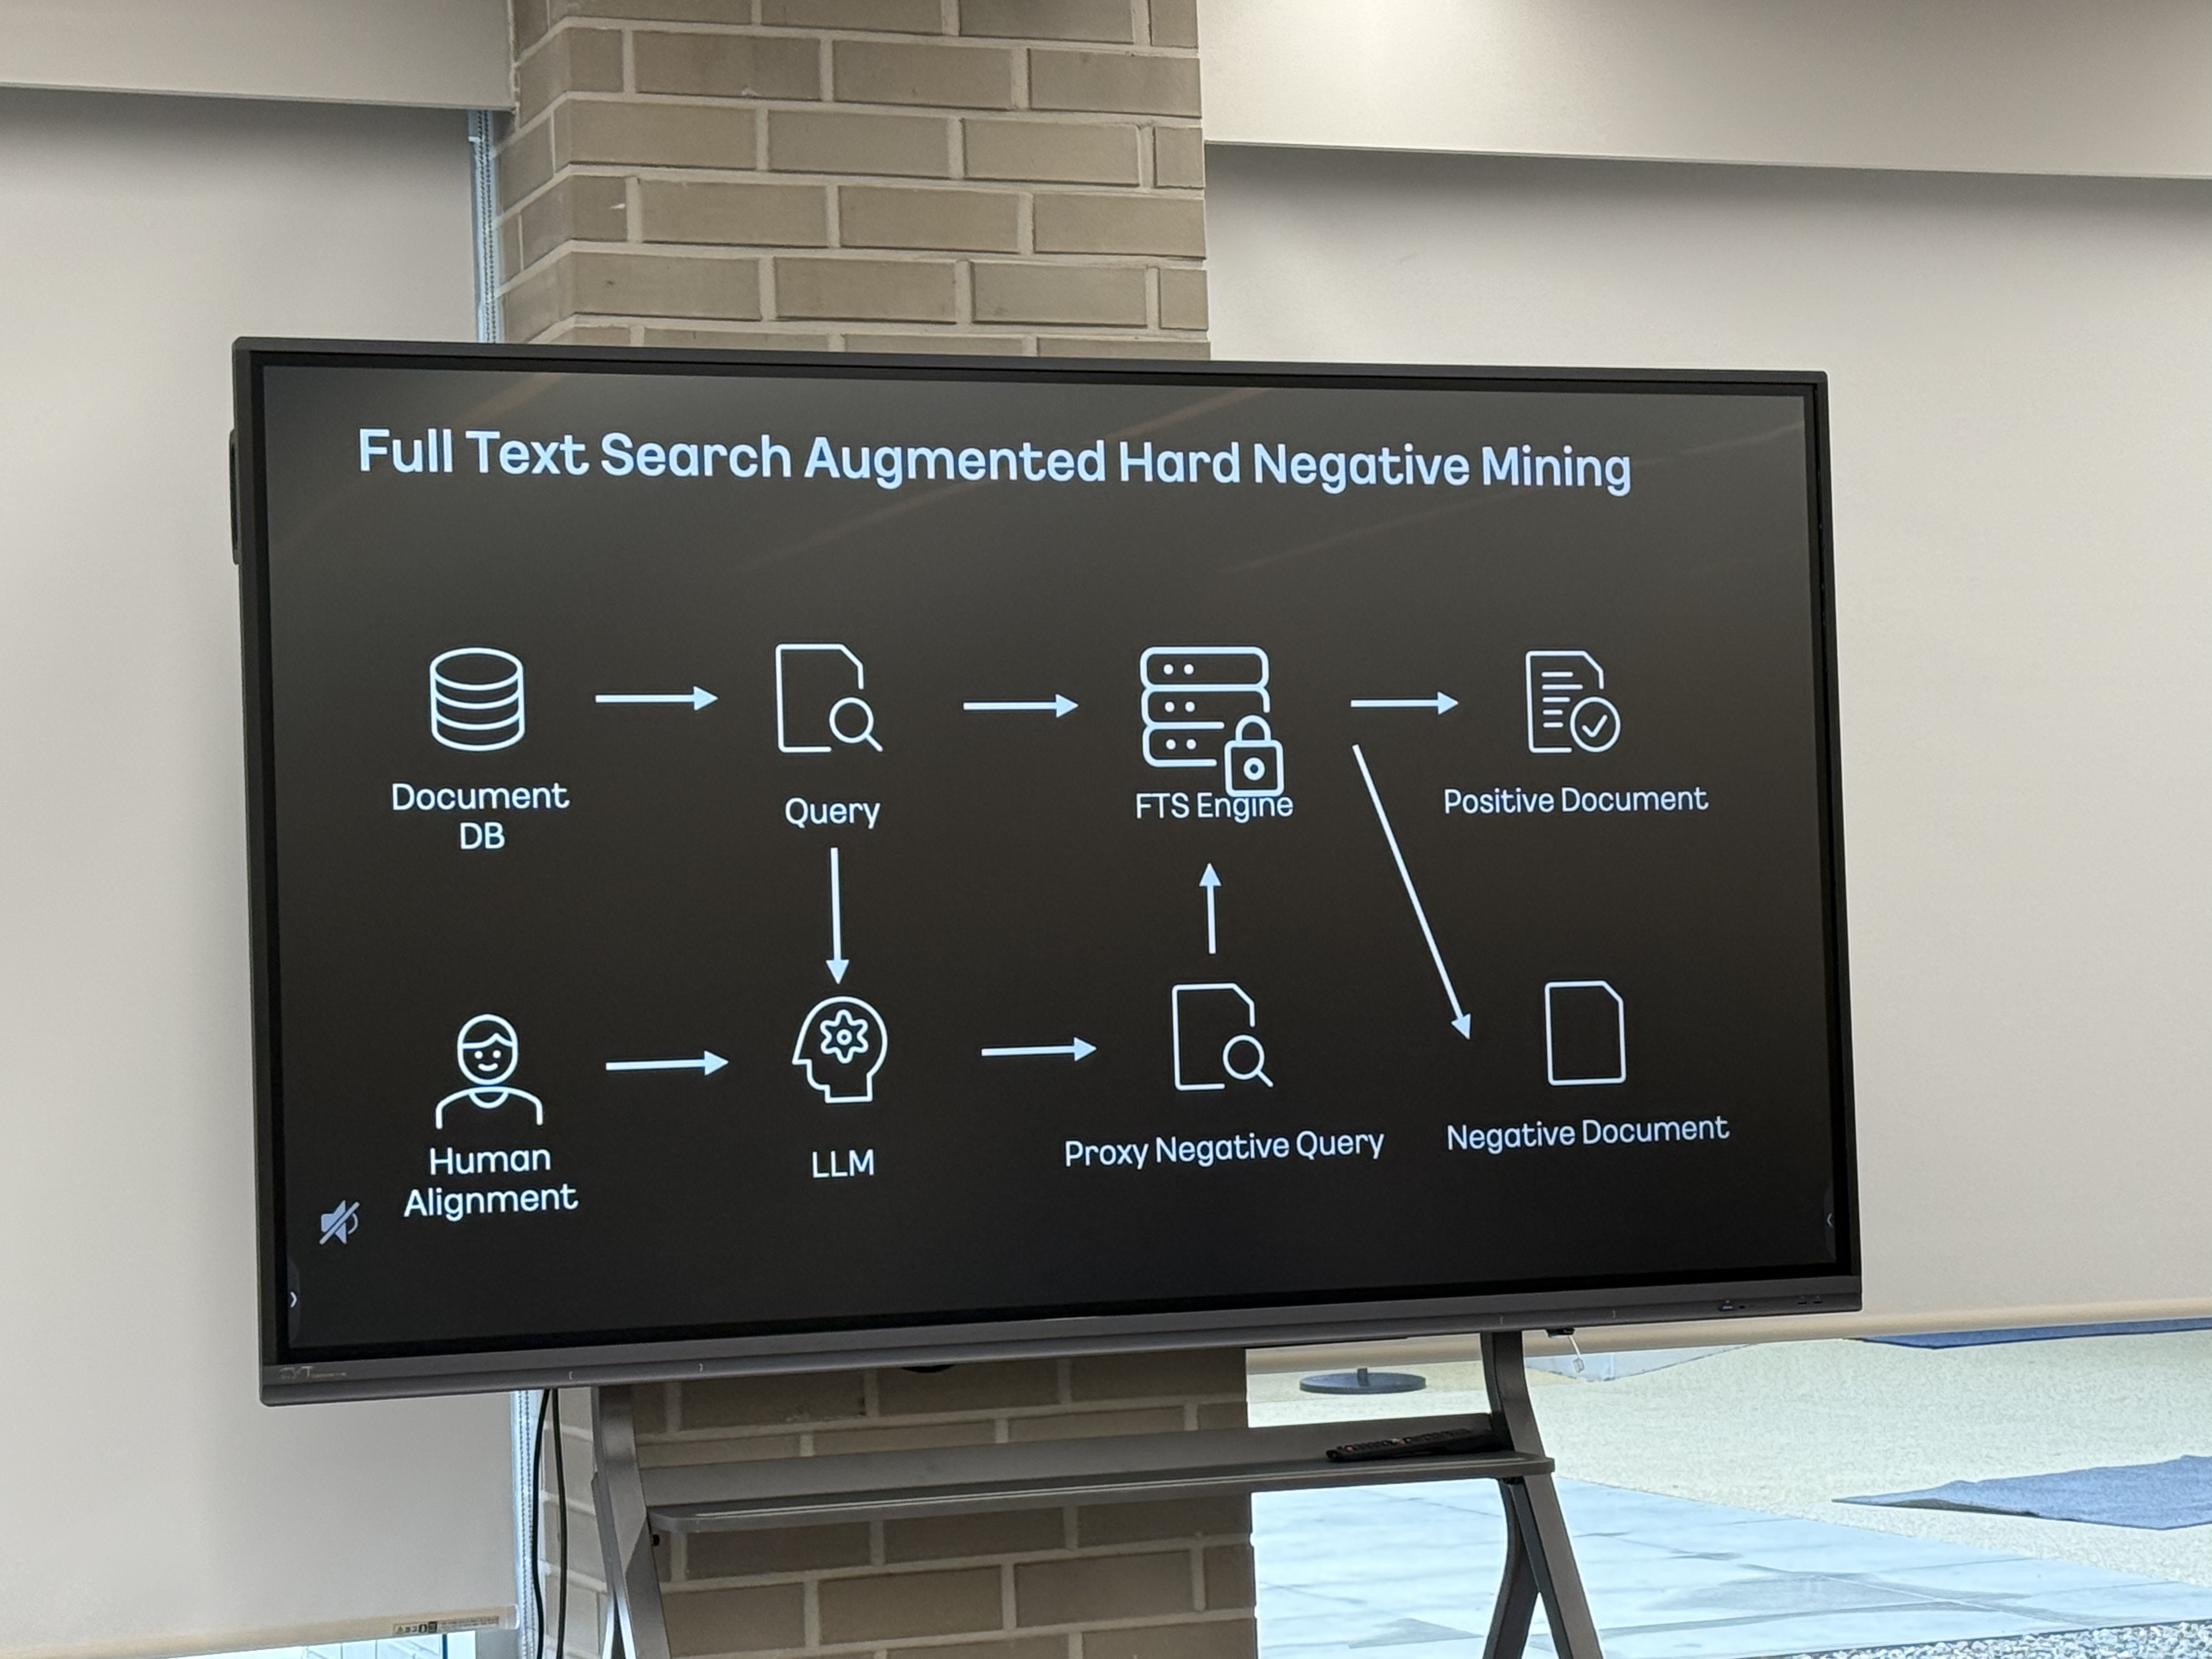
AI가 답을 잘하려면 결국 근거를 제대로 찾아와야 한다. 이 세션은 그 검색 쪽 이야기였다.
인상 깊었던 건 임베딩 검색과 키워드 검색을 함께 쓰는 하이브리드 구조다.
키워드 검색은 오탈자나 유의어에 약한데, 이걸 임베딩 기반 검색으로 보완한다.
그리고 검색 결과의 최신성과 정확성이 핵심이라고 강조했다.
유의어·오탈자 검색은 많은 서비스에서 나오는 요구사항이다. 사전 기반으로만 해결하려던 문제를 임베딩 검색으로 풀 수 있다는 걸 구체적으로 알게 됐다. 다만 임베딩 생성 비용이나 서버 운영 부담은 따져봐야 할 것 같다.
소스코드 보안 분석을 위한 하네스 설계
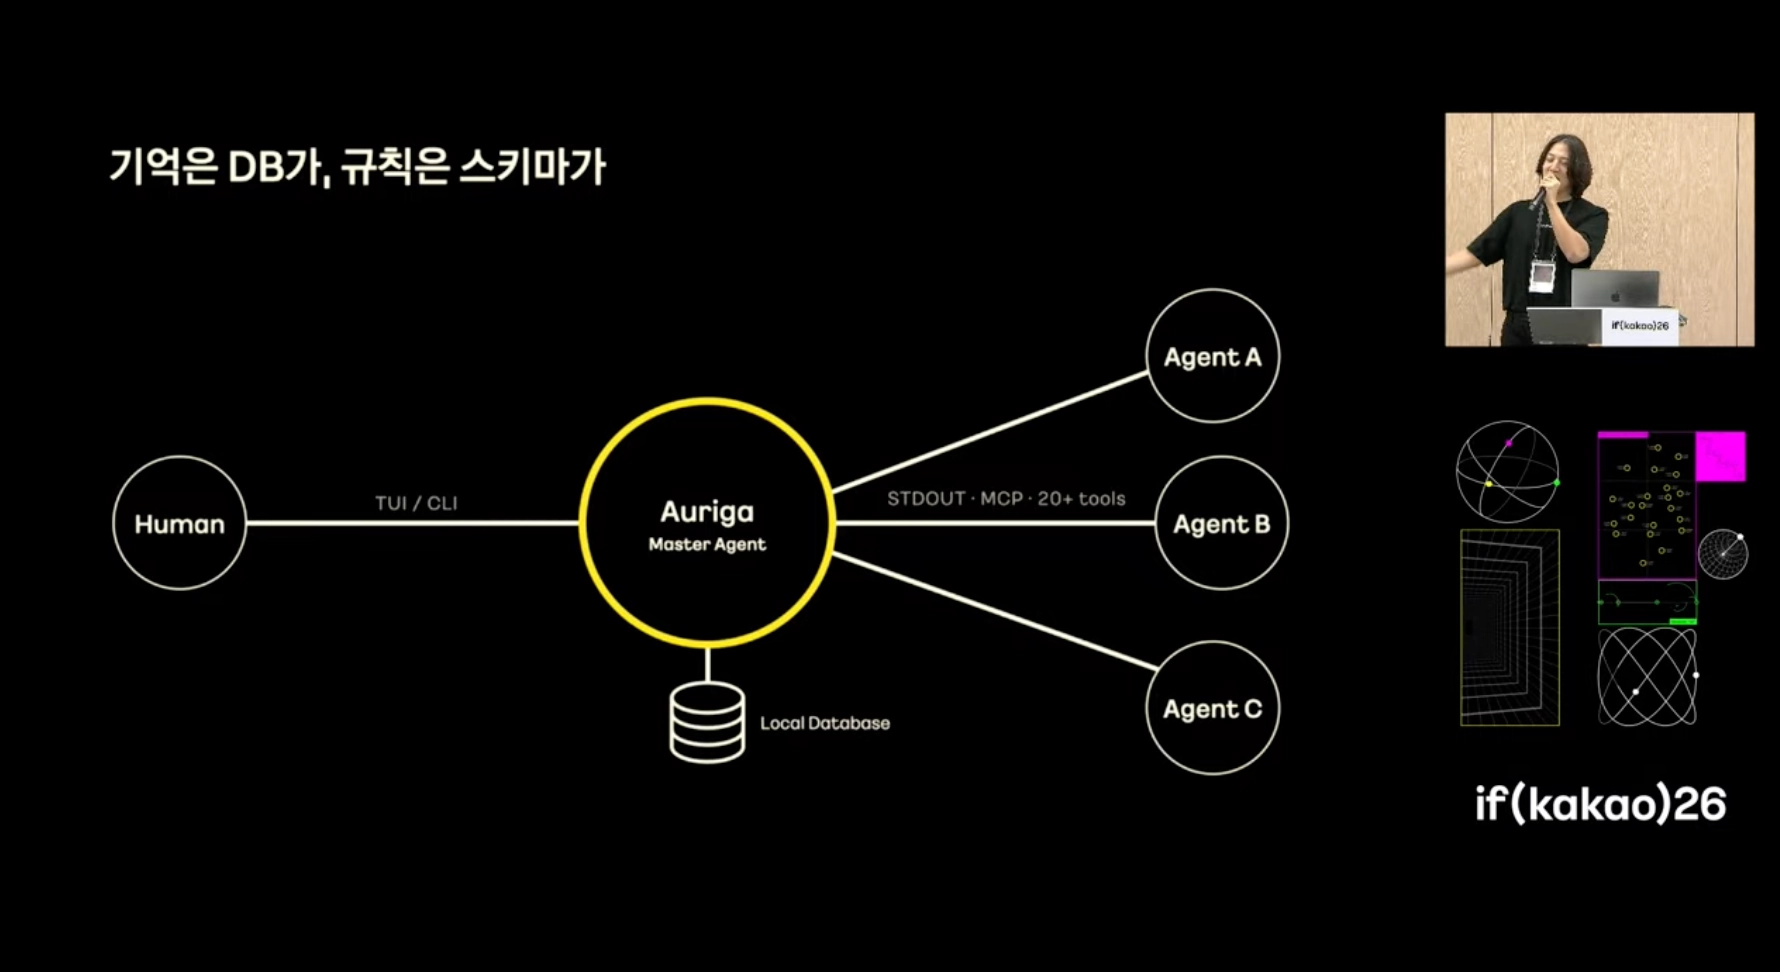
시작은 이 문제였다. 같은 모델, 같은 프롬프트여도 돌릴 때마다 결과가 다르다. 그럼 AI의 분석 결과를 어떻게 믿을 수 있을까?
이를 위해 분석 하네스를 설계했는데, 몇 가지 포인트가 기억에 남는다.
- 분석 상태를 DB에 저장하고, 기록만 전담하는 에이전트를 둔다.
- 에이전트끼리 결과를 공유하지 않는다. 다른 결과를 먼저 보면 앵커링 효과가 생겨 분석이 오히려 나빠진다.
- 데이터의 양보다 출처가 확인된 신뢰할 수 있는 데이터가 중요하다.
- 분석에 드는 비용과 시간을 데이터 기반으로 미리 추정한다.
- 에이전트가 겪은 불편함을 올리는 피드백 채널까지 운영한다.
AI 코드 분석 결과를 한 번 돌린 값 그대로 믿지 말고, 독립적으로 여러 번 돌려 교차 검증해야 한다는 게 핵심이었다.
수억건의 보안 신호 속 진짜 위협찾기
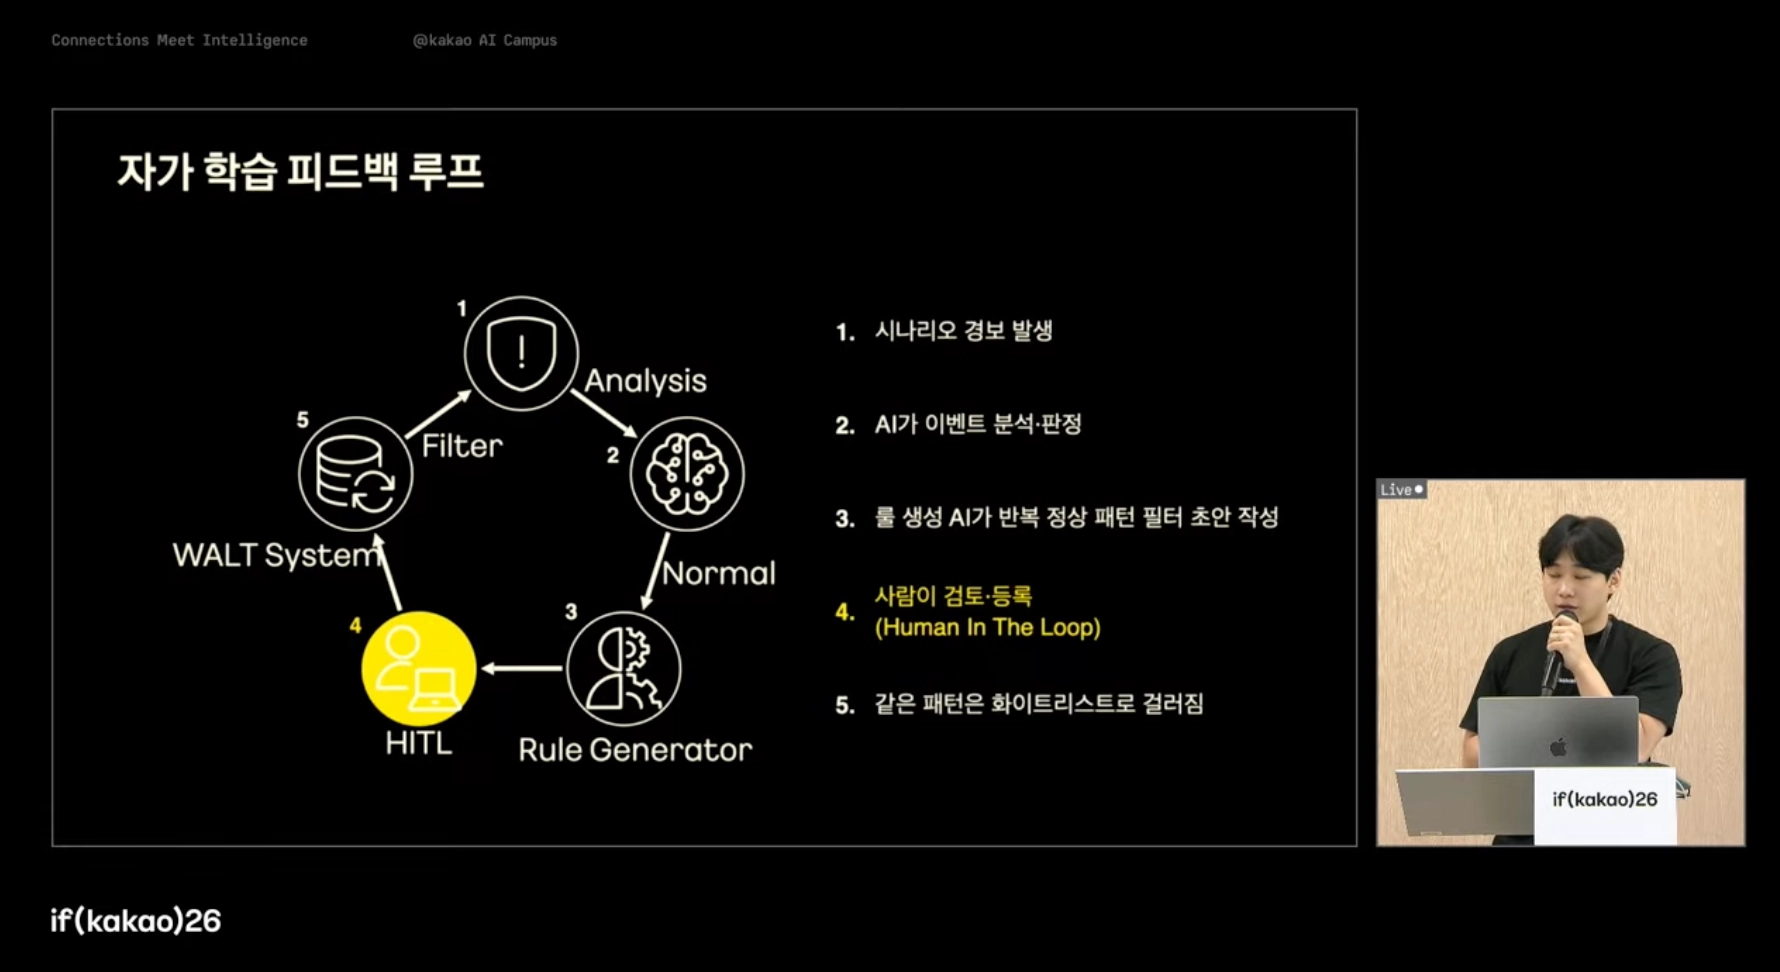
보안 이벤트를 AI로 분석하다 보면 생기는 현실적인 문제들을 다뤘다.
문제 1. 입력 토큰 한도
컨텍스트가 잘리면서 잘못된 답이 나온다. 해결책은 꼭 필요한 필드만 정제해서 보내고,
내부 정보는 AI가 이해할 수 있게 전달하는 것.
문제 2. 비용
자가 학습 피드백 루프로 해결했다.
- 경보 발생
- AI가 이벤트 분석·판정
- 룰 생성 AI가 반복되는 정상 패턴의 필터 초안 작성
- 사람이 검토·등록 (Human In The Loop)
- 같은 패턴은 화이트리스트로 걸러져 AI로 넘어가지 않음
문제 3. 데이터 할루시네이션
저장 공간 때문에 데이터를 지우면, 비어 있는 부분을 AI가 스스로 채우며 할루시네이션을 만든다.
그렇다고 전부 저장하는 것도 답이 아니다.
의미는 보존하고 표현은 압축(정규화, 축약, 공통 데이터 모델)하는 방식으로 입력 컨텍스트를 약 1/4로 줄였다고 한다.
운영 중인 서비스의 오류 알림에 AI 분석을 붙여 쓰고 있는데, 같은 오류도 매번 AI가 분석하고 있었다. 최근 발생한 같은 오류는 알림만 보내고 AI 분석은 건너뛰거나, 보내는 필드를 줄이기만 해도 비용을 꽤 줄일 수 있겠다는 생각이 들었다.
AI를 계속 쓰기 위해, 우리가 정한 것들 (파이어사이드챗)
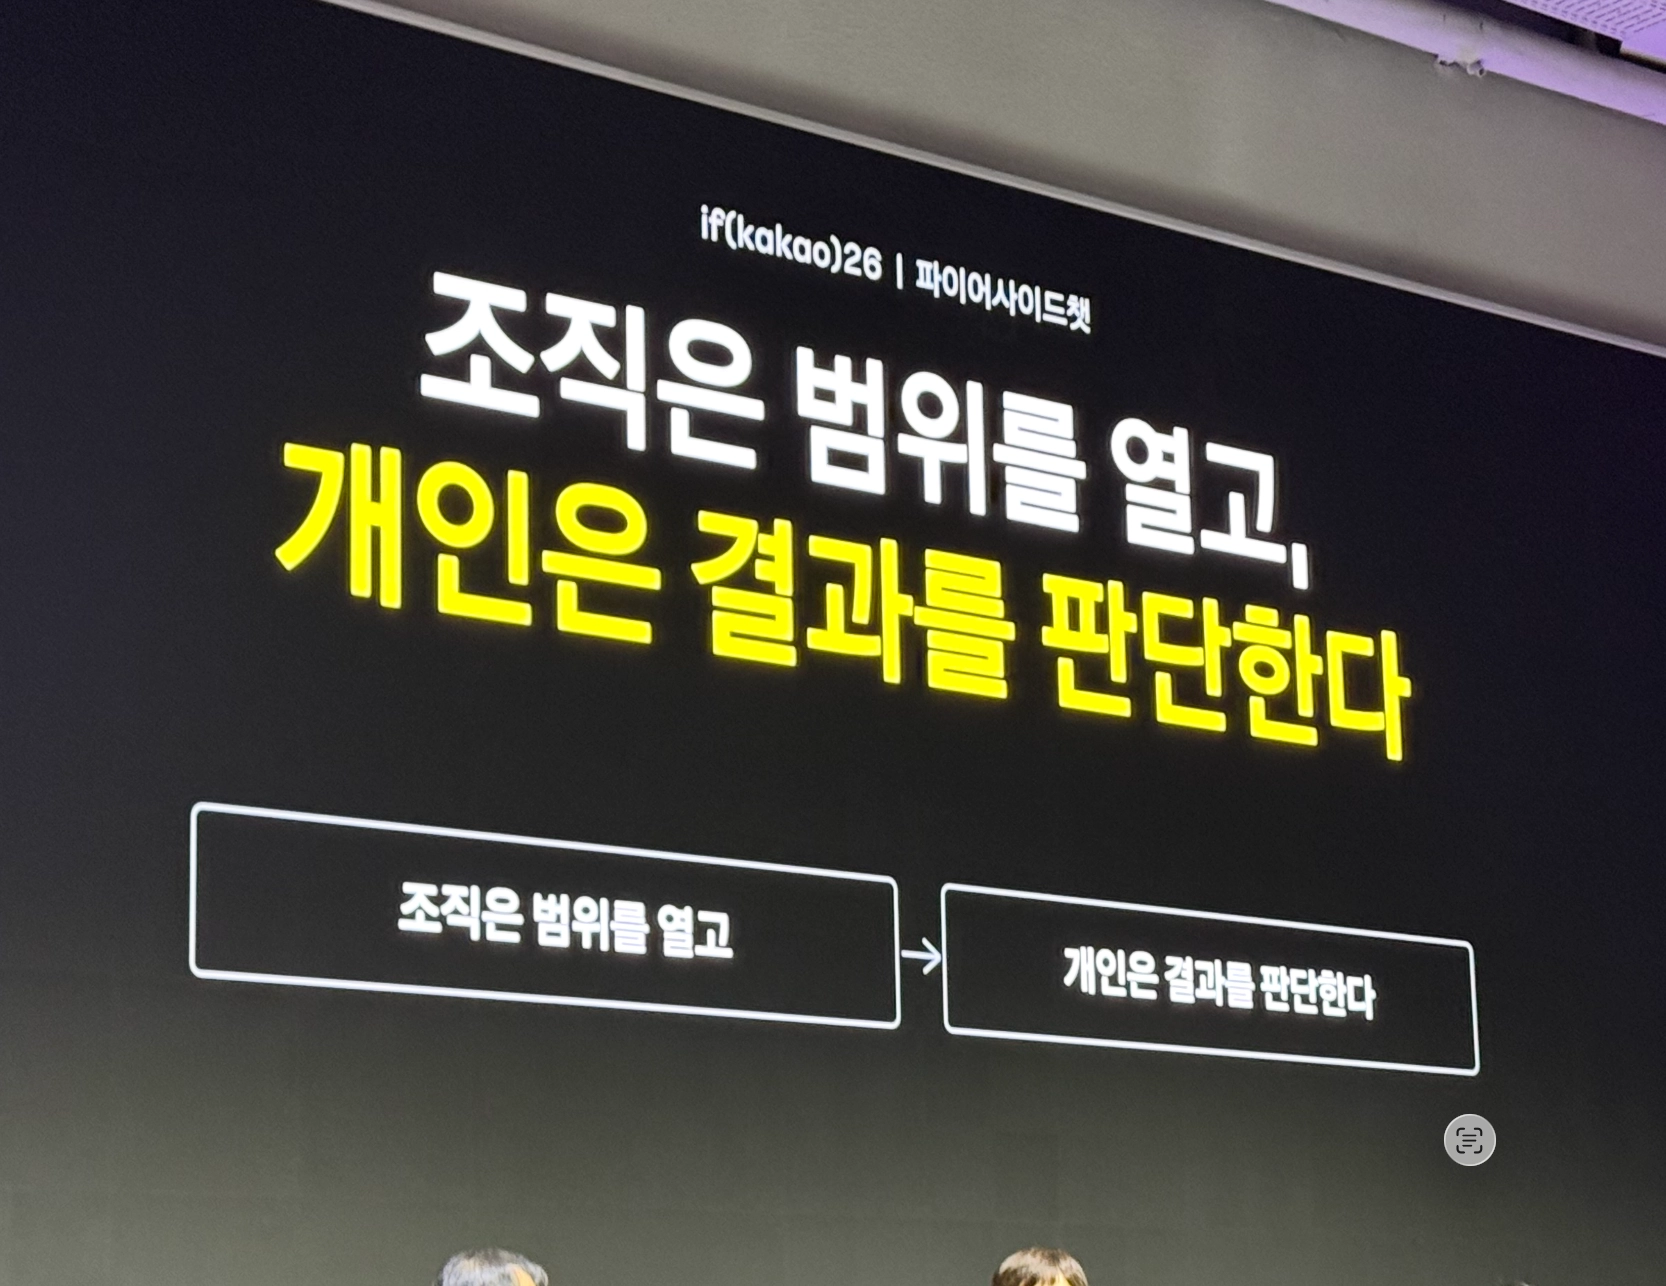
4명의 패널이 조직에서 AI를 지속적으로 쓰기 위한 기준에 대해 이야기한 토크 세션이었다. 핵심 메시지는 이 한 문장이었다.
"조직은 범위를 열고, 개인은 결과를 판단한다."
- 기술보다 경로가 먼저: "회사 코드, AI에 넣어도 돼요?"라는 질문에 회사가 한 문장으로 답할 수 있어야 한다. 공식 경로 하나에서 제어하고, 관측하고, 평가하고, 수정한다.
- 토큰이 부족할 때: 줄일 것은 모델 등급과 사고량, 남길 것은 설계와 검증. 쉬운 문제에 높은 effort를 쓰면 결과 차이도 적고 오히려 장고 끝에 악수를 둘 수 있다.
- 교차 리뷰: 다른 사람에게 코드리뷰를 맡기듯, AI도 다른 세션이나 다른 모델에게 리뷰를 시키면 결과가 달라진다.
- 역할 분담: 경로, 데이터 범위, 기본 모델은 회사가 정하고 세부 설정은 개인이 판단한다.
개인이 AI를 쓰는 것과 팀이 함께 쓰는 건 다르다는 말이 와닿았다. 무엇을 넣으면 안 되는지, 어떤 모델을 기본으로 추천하는지 정도의 가이드만 있어도 각자 고민하는 시간이 줄 것 같다.
마치며
세션 주제는 각자 달랐지만, 공통으로 이 세 가지를 이야기하고 있었다.
- AI를 쓰는 것보다 믿고 계속 쓰는 구조가 중요하다. 검증 자동화, 입력 데이터 정제, 권한과 범위 통제
- 비용은 입력을 줄이는 데서 나온다. 필요한 필드만 보내기, 반복 패턴 걸러내기, 작업 난이도별 모델 선택
- 사람의 판단은 빠지지 않는다. 자동화하더라도 최종 확인은 사람이 한다.
참고 링크
- if(kakao)26: https://if.kakao.com/2026
- 발표자료는 홈페이지, 세션별 VOD는 카카오테크 유튜브 채널에 공개 예정